STT Workbench
مقاربات تحويل الكلام إلى نص في PyTorch
ست طرق لتحويل الكلام إلى نص، مبنية بحجم صغير يكفي لمشاهدة كل منها وهي تتعلم على المعالج المركزي.
- CTC 2.4% WER (تجريبي)
- 15.1% WER على FSDD مع نموذج لغوي
التقنيات PyTorchtorchaudioBeam search
 ONNX
 Hugging Face Transformers
 NumPy
 pytest
 Kaggle
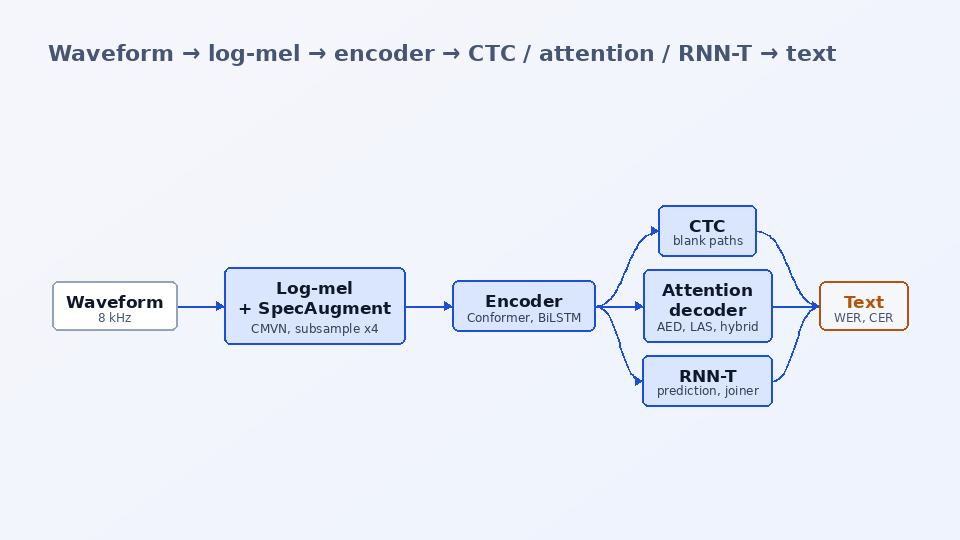
نظرة عامة
يضم التعرف التلقائي على الكلام (Automatic Speech Recognition) عدة عائلات من النماذج تحل المسألة الصعبة نفسها بطرق مختلفة: محاذاة متتالية طويلة من إطارات الصوت مع متتالية قصيرة من الحروف. أردت أن أرى هذه الفروق بنفسي بدلاً من القراءة عنها، فكتبت كل مقاربة في قاعدة شيفرة PyTorch صغيرة واحدة تتشارك فيها الواجهة الأمامية والمُرمِّزات والمدرِّب والتقييم.
النماذج هي CTC، ومُرمِّز-مفكك بالانتباه، وListen-Attend-Spell، والهجين CTC/الانتباه، وRNN-Transducer، على مُرمِّزات BiLSTM أو Transformer أو Conformer، إضافة إلى مغلِّفات للضبط الدقيق (fine-tuning) لـ wav2vec2 وWhisper في الدفتر. وكل خوارزميات فك الترميز موجودة أيضاً: الجشع، وبحث الحزمة البادئي لـ CTC (CTC prefix beam search) مع نموذج لغة n-gram، وبحث الحزمة بالانتباه مع تسجيل البادئة بـ CTC، والفك الجشع وmodified beam search لـ RNN-T. تحتوي النماذج على 1 إلى 1.3 M معامل افتراضياً.
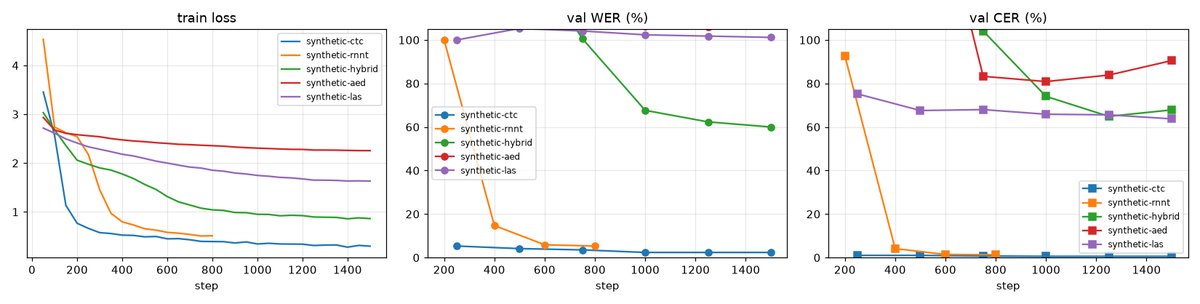
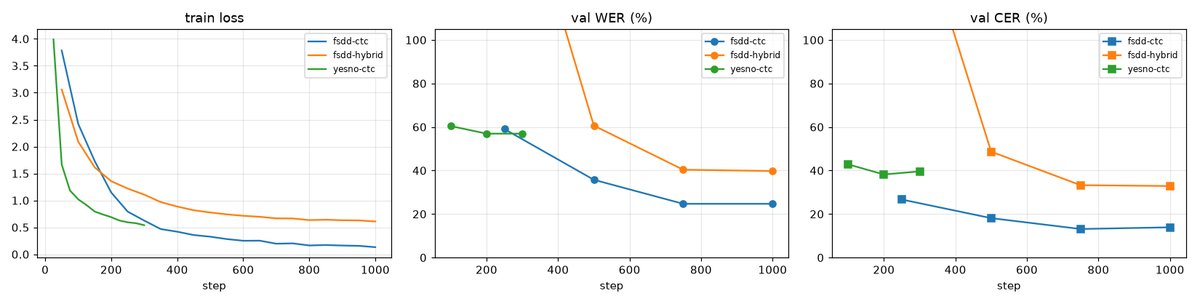
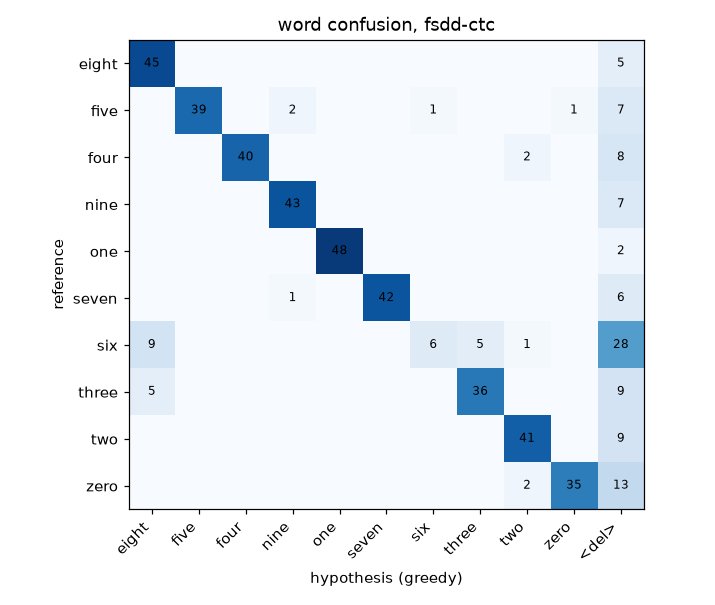
اختبرته على بيانات بسيطة بتردد 8 kHz تتدرب في دقائق على المعالج المركزي: لغة تجريبية اصطناعية، وFree Spoken Digit Dataset، وYESNO. يبلغ CTC معدل خطأ كلمات (WER) قدره 2.4% على اللغة التجريبية؛ وعلى FSDD مع متحدث محجوز للاختبار يحقق نموذج CTC 24.7% بالفك الجشع و15.1% مع بحث الحزمة ونموذج لغة 5-gram على مستوى الحروف. تُظهر هذه التشغيلات أن كل مقاربة تتعلم وأن مفككات الترميز تعمل؛ وهي ليست مقاييس معيارية، فالتدريب الحقيقي مكانه دفتر Kaggle/Colab.
السؤال
إذا تشاركت نماذج CTC والانتباه والمحوِّل (transducer) الواجهة الأمامية نفسها والمُرمِّزات نفسها والمدرِّب نفسه، فما الذي يحتاجه كل منها فعلاً لتعلم المحاذاة بين إطارات الصوت والنص؟
أهم الميزات
- خمسة نماذج قابلة للتدريب خلف خيار واحد: CTC، ومُرمِّز-مفكك بالانتباه، وLAS مع انتباه واعٍ بالموضع، والهجين CTC/الانتباه، وRNN-Transducer.
- ثلاثة مُرمِّزات يستطيع أي نموذج استخدامها، BiLSTM وTransformer وConformer، بعد واجهة أمامية log-mel مع CMVN وSpecAugment وتقليص التفافي بمعامل 4x.
- كل مفككات الترميز: الجشع، وبحث الحزمة البادئي لـ CTC مع نموذج لغة n-gram مُستكمَل، وبحث الحزمة بالانتباه مع إعادة التسجيل بالبادئة عبر CTC، والفك الجشع وmodified beam search لـ RNN-T.
- مجموعات بيانات مدمجة تُكتب أو تُنزَّل بأمر واحد (لغة تجريبية اصطناعية، وYESNO، وFSDD، وLibriSpeech، وLJSpeech، وCommon Voice) مع تجميع الدفعات حسب المدة.
- تقييم WER / CER مع محاذاة أسوأ العبارات، ومصفوفة التباس للكلمات، ونص برمجي يقارن مفككات الترميز على نقطة الحفظ نفسها.
- تصدير ONNX للمُرمِّز ورأس CTC، ومغلِّفات الضبط الدقيق لـ wav2vec2 وWhisper، ودفتر Kaggle/Colab مولَّد من الشيفرة المصدرية للحزمة.
- 80 اختباراً في نحو 10 ثوانٍ على المعالج المركزي، منها حالة يخطئ فيها فك ترميز CTC الجشع ويصيب فيها بحث الحزمة البادئي.
كيف يعمل
الواجهة الأمامية
تتحول الموجة الصوتية إلى مخطط طيفي log-mel بـ 80 نطاقاً، مطبَّع لكل عبارة (CMVN) ومقنَّع في الزمن والتردد بواسطة SpecAugment أثناء التدريب.
الترميز
يقلّص التفافان بخطوة الإطارات بمعامل أربعة، ثم تبني طبقات BiLSTM أو Transformer أو Conformer سمات صوتية سياقية.
محاذاة الإطارات مع الرموز
يجمع CTC على كل مسارات الإطارات التي تختزل إلى النص المكتوب؛ وتتعلم مفككات الانتباه محاذاة مرنة عبر الانتباه المتقاطع؛ ويدمج RNN-T المُرمِّز مع شبكة تنبؤ على شبكية رتيبة.
التدريب
رموز حرفية أو SentencePiece، وAdam مع إحماء، ودفعات مجمَّعة حسب المدة، وWER / CER على التحقق عند كل تقييم، ونقاط حفظ قابلة للاستئناف.
فك الترميز والتقييم
فك جشع أو بحث حزمة، مدمج اختيارياً مع نموذج لغة n-gram؛ ويحاذي stt-eval الفرضيات مع المراجع ويطبع WER وCER وأسوأ العبارات.
أمثلة
المدخل
stt-train --data-dir data/synthetic --sample-rate 8000 --model ctc --encoder conformer --d-model 96 --n-layers 4 --max-steps 1500 --output-dir checkpoints/ctc && stt-eval data/synthetic/val.jsonl hyps.jsonl
المخرج
val WER 2.4%, CER 0.6% (1.04 M parameters, 20 min on one CPU with two threads)
المدخل
python scripts/compare_decoders.py # same CTC checkpoint, 166 FSDD validation clips
المخرج
greedy: 24.7% WER | beam 8: 24.1% | beam 8 + character 5-gram LM (weight 0.3): 15.1%
التقنيات المستخدمة
كل نموذج ومُرمِّز ودالة خسارة وخوارزمية بحث
خسارة RNN-T (اعتمادية اختيارية)
Beam search
بحث الحزمة البادئي لـ CTC، وبحث الحزمة بالانتباه مع إعادة التسجيل بـ CTC، وmodified beam search لـ RNN-T
تصدير المُرمِّز ورأس CTC
مغلِّفات الضبط الدقيق لـ wav2vec2 وWhisper (اعتمادية اختيارية)
توليد اللغة التجريبية الاصطناعية
80 اختباراً، نحو 10 ثوانٍ على المعالج المركزي
دفتر مولَّد للتدريب الحقيقي على GPU مجاني
ما تعلمته
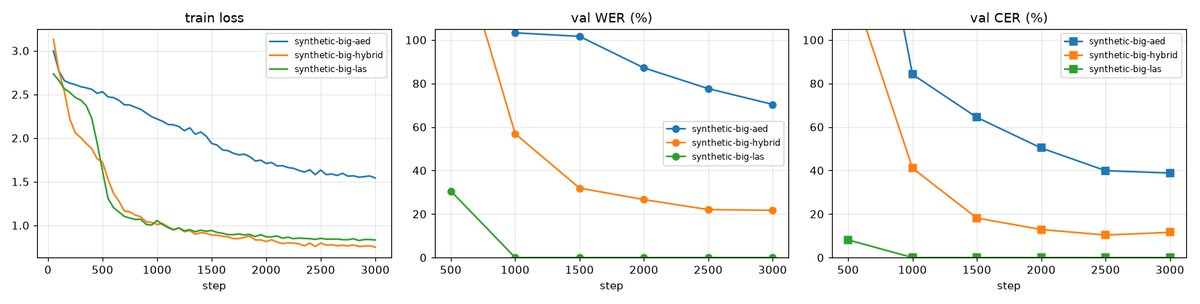
- يحصل CTC وRNN-T على محاذاة رتيبة مجاناً، بينما يتعين على مفككات الانتباه اكتشاف أين تنظر، وهذا يكلف بيانات وخطوات
- لا يفيد نموذج اللغة إلا إذا كانت للغة بنية: فقد خفّض WER على FSDD من 24.7% إلى 15.1% ولم يغيّر شيئاً على كلمات من حروف عشوائية
الحدود
- كل النتائج تشغيلات قصيرة على المعالج المركزي ببيانات 8 kHz (التجريبية وFSDD وYESNO)، وليست مقاييس معيارية؛ ولا تُنشر أرقام LibriSpeech ولا أوزان مدرَّبة مسبقاً
- يبقى تشغيل YESNO (42 مقطع تدريب) عند WER 56.9%؛ وهو يتحقق فقط من أن خط المعالجة يعمل على صوت حقيقي
الكلمات المفتاحية
التعرف على الكلام · ASR · تحويل الكلام إلى نص · CTC · RNN-Transducer · RNN-T · Listen Attend and Spell · مُرمِّز-مفكك بالانتباه · الهجين CTC/الانتباه · Conformer · BiLSTM · Transformer · بحث الحزمة البادئي · نموذج لغة n-gram · SpecAugment · المخطط الطيفي log-mel · WER · CER · wav2vec2 · Whisper · PyTorch · ONNX · FSDD · LibriSpeech